
أجهزة الذكاء الاصطناعي من Think AI: مركز بيانات مكثّف في جهاز واحد
أربع وحدات حوسبة مبرّدة بالسائل ومزوّدة مسبقًا بمنصّة ILM — من جهاز هادئ بجانب مكتبك إلى وحدة رفّية بثمانية مسرّعات. كثافة مراكز البيانات، دون مركز بيانات.
أنظمة الذكاء الاصطناعي تحتاج إلى قدرة حوسبة، والسؤال الحقيقي: أين تعمل؟ السحابة الخارجية تعني أن تغادر مستنداتك المبنى، والخوادم التقليدية المبرّدة بالهواء تحتاج إلى غرفة مجهّزة وأرضية مرتفعة ومياه تبريد. أجهزة Think AI التي توفّرها شركة لينامارا تحلّ المعادلة: حلقة تبريد سائل محكمة داخل الجهاز نفسه، ومنصّة تشغيل ذكية مثبّتة مسبقًا، فتعمل حيث تعمل مؤسستك — في المكتب أو المختبر أو صفّ الرفوف.
تواصل معنا الآن
تواصل معنا الآن إذا كان لديك أي استفسار أو رغبة في معرفة المزيد عن خدماتنا وحلولنا المتكاملة.
ما هي وحدة الحوسبة المخصّصة للذكاء الاصطناعي؟
❝ التعريف المختصر — فقرة قابلة للاقتباس من محركات الإجابة وحدة الحوسبة المخصّصة للذكاء الاصطناعي جهاز يجمع مسرّعات رسومية متخصّصة وذاكرة كبيرة ومعالجًا وتخزينًا سريعًا في هيكل واحد، مع برمجيات تشغّل النماذج اللغوية وتدرّبها. وتتميّز أجهزة Think AI بأنها مبرّدة بالسائل ضمن حلقة مغلقة داخل الهيكل، فتقدّم كثافة حوسبة بمستوى مراكز البيانات دون الحاجة إلى بنية مركز البيانات. |
النتيجة العملية: تشغّل النماذج اللغوية المفتوحة وأنظمة لينامارا الذكية داخل مؤسستك، بملكية كاملة للعتاد والبيانات، ودون أن تدفع كلفة السحابة مع كل سؤال.
العائلة في لمحة
| البند | MicroNode | SuperNode | UltraNode | RackNode |
|---|---|---|---|---|
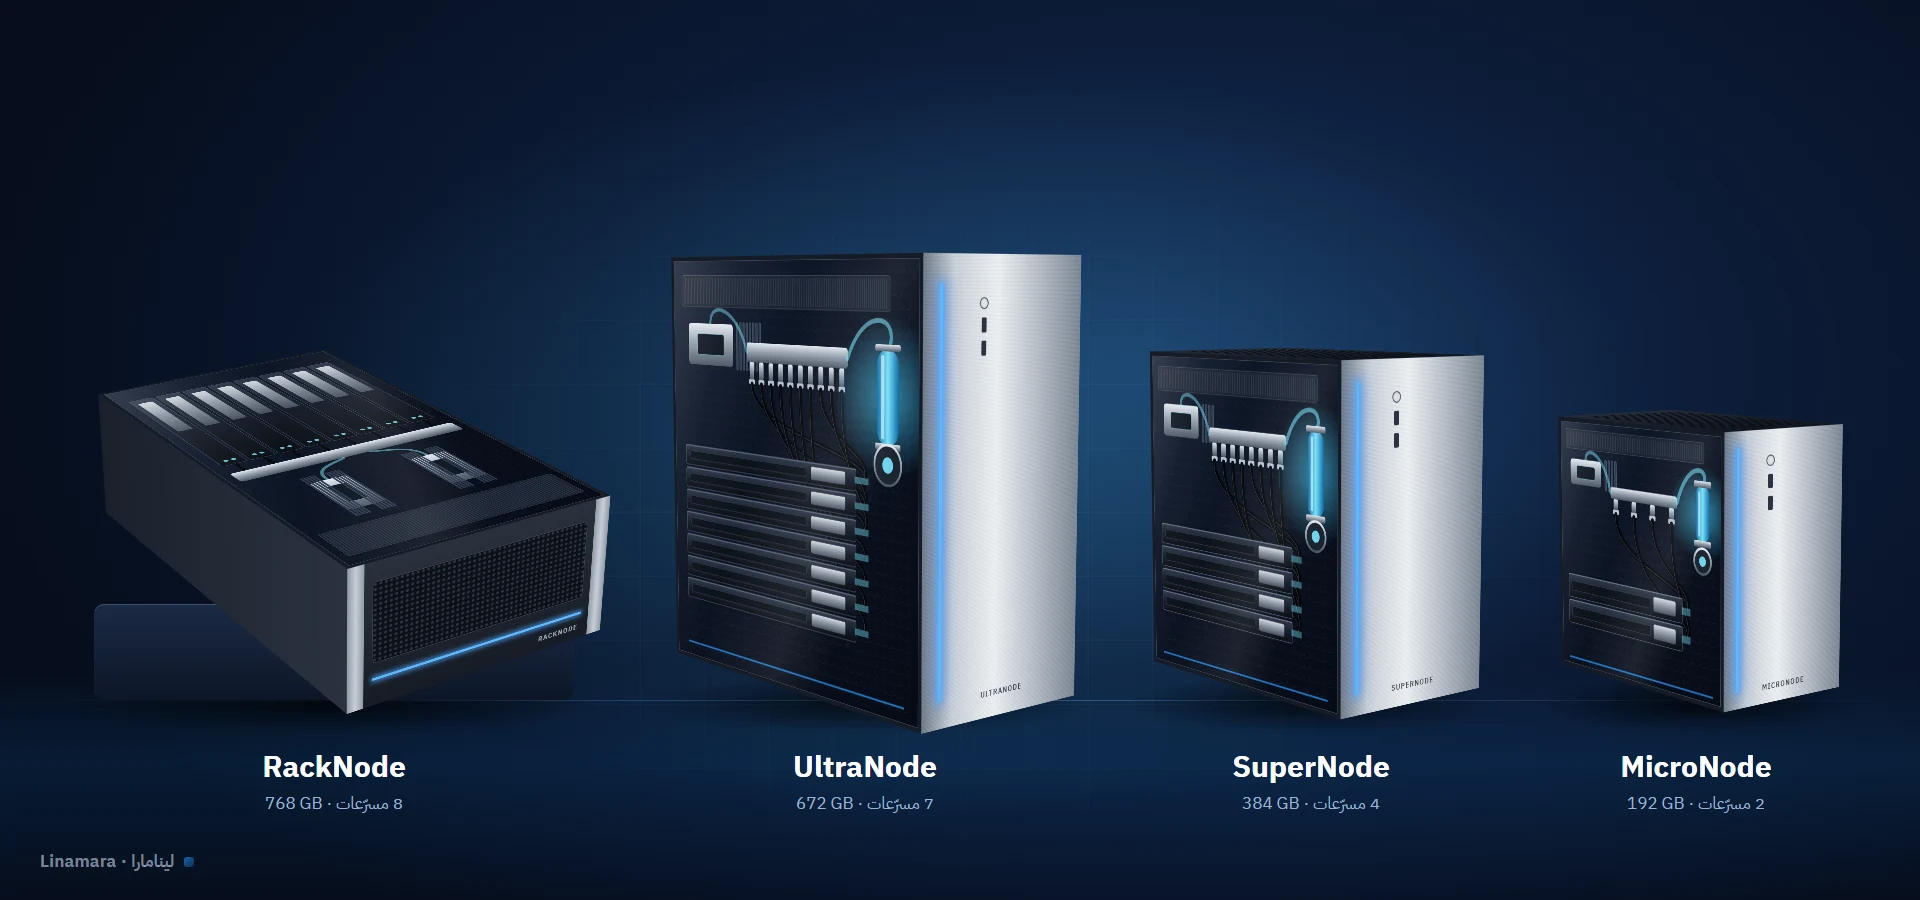
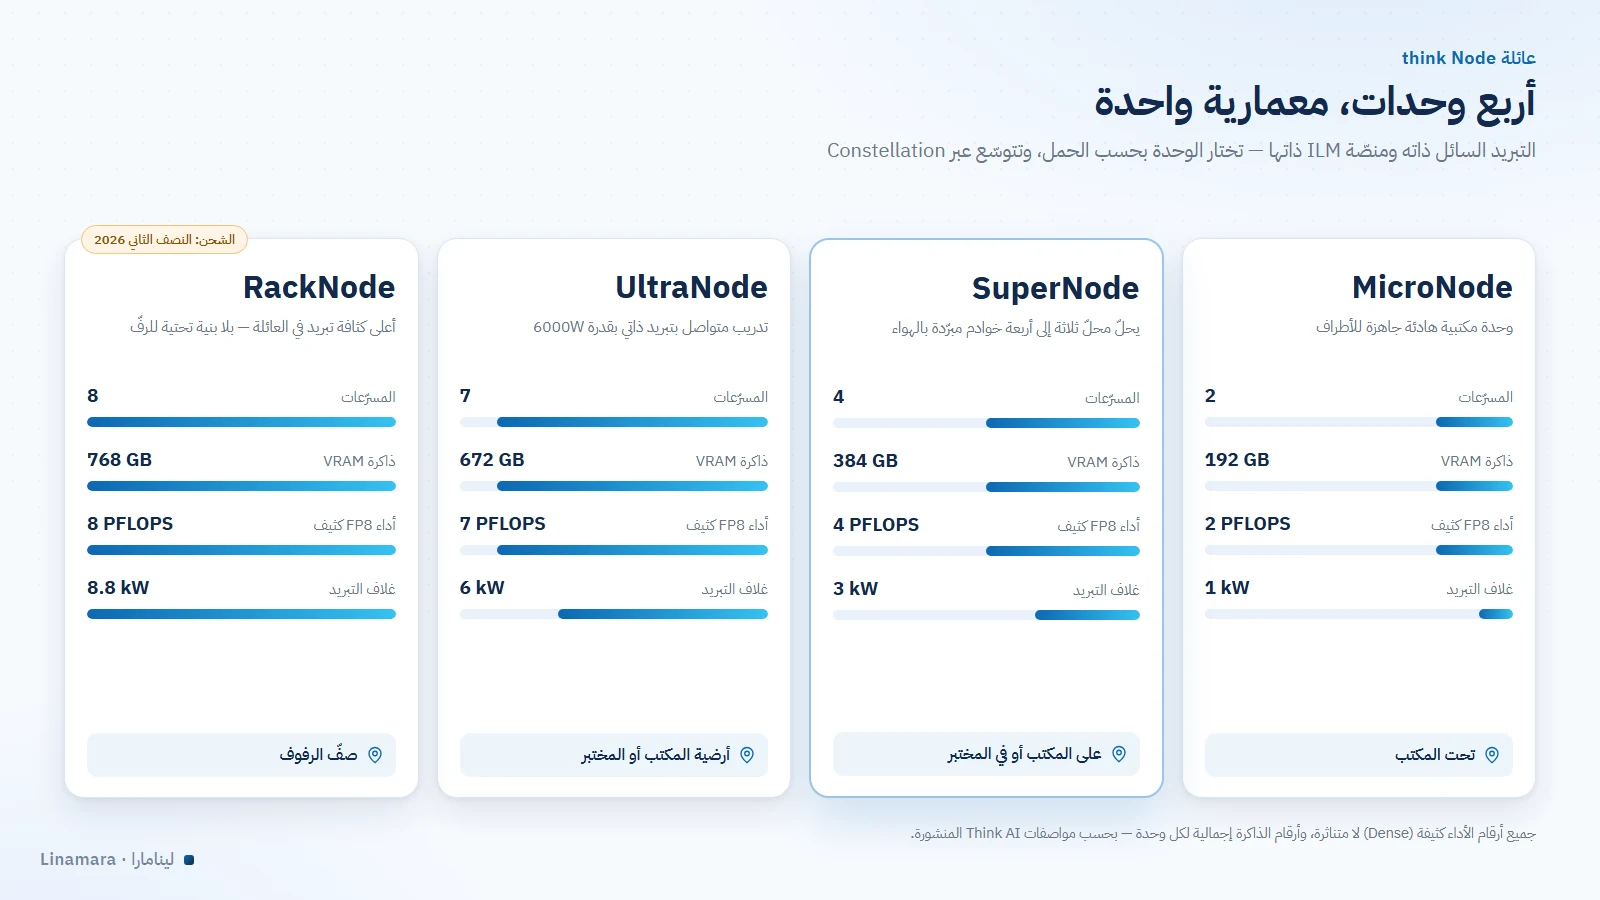
| المسرّعات (NVIDIA RTX PRO 6000) | 2 | 4 | 7 | 8 |
| ذاكرة VRAM الإجمالية | 192 GB | 384 GB | 672 GB | 768 GB |
| أداء FP8 (كثيف) | 2 PFLOPS | 4 PFLOPS | 7 PFLOPS | 8 PFLOPS |
| المعالج | Ryzen 9 9950X | Threadripper PRO 9985WX | Threadripper PRO 9995WX | 2 × EPYC 9575F |
| الذاكرة الرئيسية | 256 GB | 512 GB | 1 TB | 1.5 TB |
| التخزين (NVMe Gen5) | 2 × 8 TB | 4 × 8 TB | 4 × 8 TB | 4 × 8 TB |
| غلاف التبريد | 1 kW | 3 kW | 6 kW | 8.8 kW |
| مكان العمل | تحت المكتب | المكتب أو المختبر | أرضية المكتب أو المختبر | صفّ الرفوف |
| التوفّر | متاح للطلب | متاح للطلب | متاح للطلب | الشحن: النصف الثاني 2026 |
جميع أرقام الأداء كثيفة (Dense) لا متناثرة، وأرقام الذاكرة إجمالية لكل وحدة — بحسب مواصفات Think AI المنشورة (الإصدار v1.4).
التبريد السائل بالتصميم
معظم الأجهزة تنفق طاقتها في تحريك الهواء؛ أجهزة Think AI تنقل الحرارة. غلاف واحد محكم، وحلقة سائل واحدة، وطبقة تشغيل واحدة — صُمّمت معًا كنظام واحد:
- لا مياه تبريد من المبنى: منظومة التبريد كاملة داخل الهيكل، ولا شيء يُمدّ إلى البناء.
- لا أرضية مرتفعة ولا غرفة خاصة: مكتب أو مختبر أو صفّ رفوف — الجهاز يعمل حيث تضعه.
- تبريد مباشر للشرائح: صفيحة تبريد على كل مسرّع وعلى المعالج أيضًا، فتبقى حرارة الشريحة تحت الحمل المتواصل أعلى من حرارة الغرفة بنحو 15 إلى 20 درجة مئوية فقط.
- صيانة أثناء التشغيل: وصلات سريعة لا تسرّب وحماية نشطة من التسرّب، ويمكن إخراج بطاقة دون تفريغ الجهاز.
- كثافة تبريد أعلى بـ 12.7 ضعفًا من رفّ مركز البيانات، مقيسةً على الحجم الكلّي للنظام — بحسب أرقام الشركة المصنّعة.
- أربع براءات اختراع قيد التسجيل لدى الشركة المصنّعة.
ثلاث طبقات، منظومة واحدة
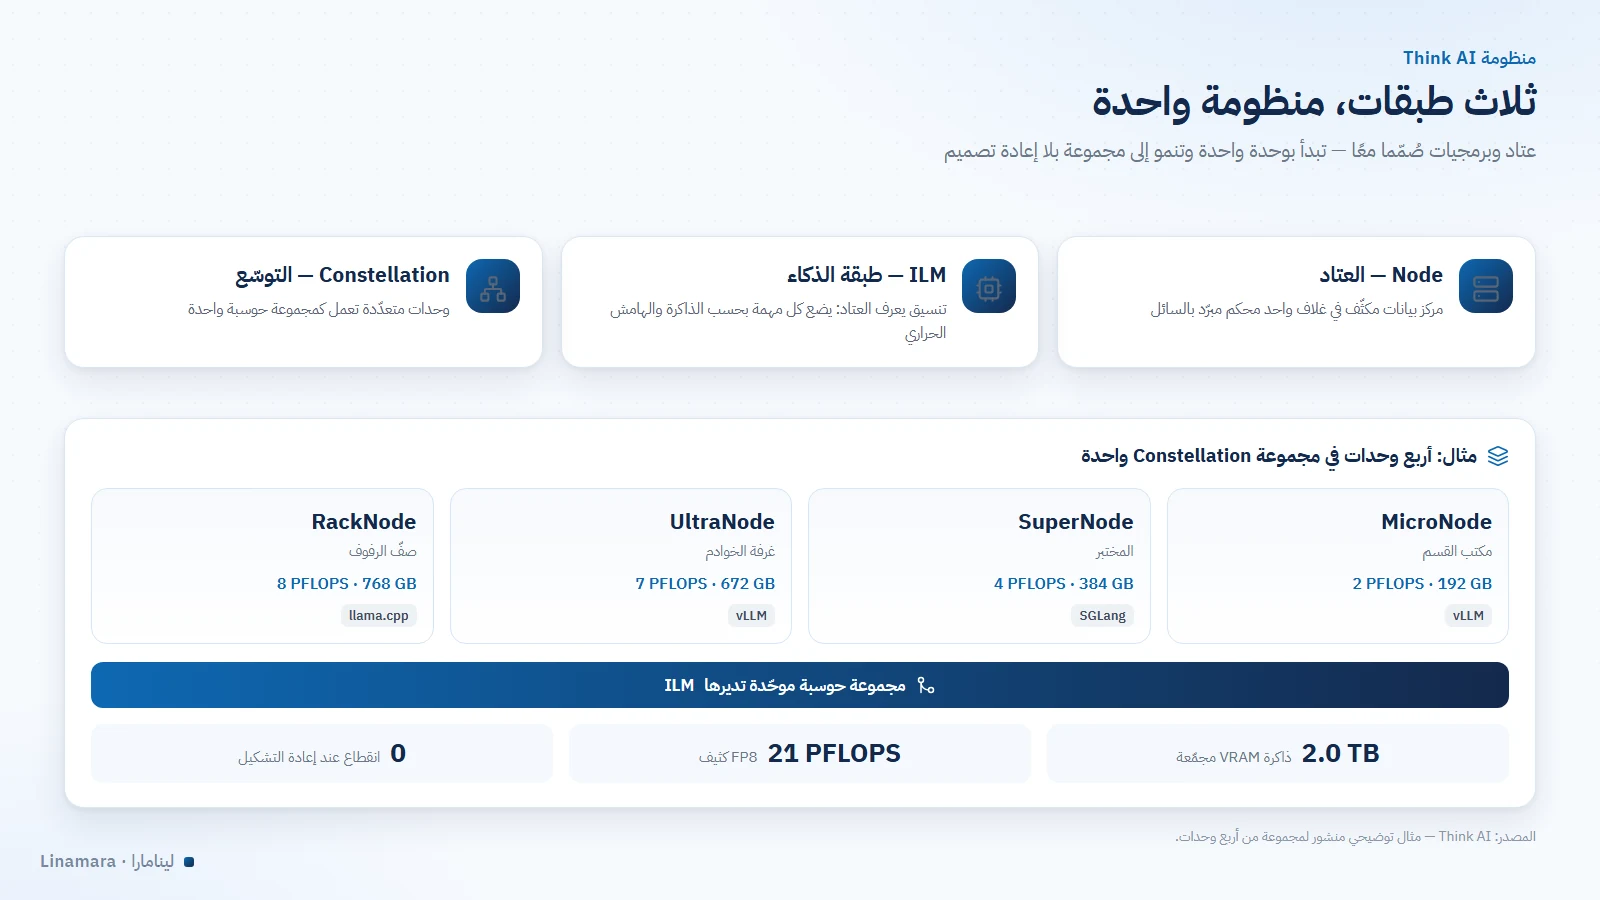
Node هو العتاد، وILM هي طبقة الذكاء التي تشغّله، وConstellation تجمع الوحدات في مجموعة حوسبة واحدة. كل طبقة تعمل وحدها، ومعًا تصنع المنظومة:
- منصّة ILM (Intelligent LLM Management): مثبّتة مسبقًا بترخيص لسنة على كل جهاز. تضع كل مهمة بحسب الذاكرة المتاحة والهامش الحراري الفعلي، فتشترك النماذج في المسرّع الواحد، ويتوزّع النموذج الكبير على عدة مسرّعات، ويجري التدريب بجانب الخدمة. وتشغّل محرّكات معروفة مثل vLLM وSGLang وllama.cpp، وأدوات التدريب Unsloth وHugging Face وLlamaFactory.
- ضبط النماذج على بياناتك: بتقنيات SFT وLoRA وQLoRA على الجهاز الذي يخدم المستخدمين نفسه — وهو ما لا تتيحه واجهات النماذج المغلقة التي لا تملك أوزانها.
- Constellation: تربط أي مزيج من الأجهزة في مجموعة واحدة؛ ففي مثال الشركة المصنّعة تعمل أربع وحدات بذاكرة مجمّعة قدرها 2.0 TB وأداء 21 PFLOPS، مع إعادة تشكيل دون انقطاع.
- كفاءة مقيسة: استغلال مستدام بنسبة 92.3% تحت حمل متعدّد النماذج، مقابل 30 إلى 50% في معظم عناقيد الحوسبة — بحسب قياسات Think AI.
لماذا تشغّل الذكاء الاصطناعي على أجهزة تملكها؟
- السيادة: المستندات والأسئلة والنماذج لا تغادر المبنى، ويمكن العمل معزولًا تمامًا عن الشبكات الخارجية.
- الكلفة: كلفة إنتاج الإجابات على جهاز تملكه أقل بكثير من استدعاء النماذج السحابية مع كل سؤال — تقدّرها الشركة المصنّعة بنحو العُشر.
- التخصيص: نموذج تملك أوزانه يمكن تدريبه على عقودك وسجلاتك ولغتك.
- الأداء: استجابة لا تتأثّر بجودة الاتصال بالإنترنت.
أنظمة لينامارا التي تعمل عليها
| نظام لينامارا | ما يستفيده من أجهزة Think AI |
|---|---|
| الذكاء الاصطناعي في معالجة المستندات | قراءة وفهم واستخراج بنماذج تعمل داخليًا وبسرعة عالية |
| التحدّث إلى البيانات | نموذج لغوي وفهرس دلالي داخل المبنى لإجابات فورية |
| رقمنة المستندات المادية | قراءة آلية وفهرسة ذكية في موقع المشروع دون إرسال الصور خارجه |
| نظام إدارة المستندات الذكي | تصنيف تلقائي وبحث دلالي على بنية المؤسسة |
| مساعد الذكاء الاصطناعي | نماذج مفتوحة مضبوطة على مصطلحات المؤسسة |
ما الذي تقدّمه لينامارا
- تحديد الحجم: نقدّر معك الجهاز المناسب من النماذج والأحجام وعدد المستخدمين، ونعرض الحسابات.
- التوريد والتركيب: تسليم الجهاز وتركيبه وتشغيله في موقعك.
- التكامل: ربط الجهاز بأنظمة لينامارا الذكية وببرنامج «أرشف» وأنظمتك القائمة.
- التدريب والدعم: تدريب فريقك ودعم محلي مباشر، مع ضمان الشركة المصنّعة: 3 سنوات للعتاد وسنة دعم للبرمجيات، مع مستويات خدمة Premium وMission-Critical عند الطلب.
احجز جلسة تحديد الحجم
أخبرنا بالنماذج التي تريد تشغيلها وحجم الاستخدام المتوقّع، ونحدّد لك الجهاز — أو مجموعة الأجهزة — المناسب مع الحسابات التفصيلية، ثم نعدّ لك عرض السعر.
◀ اطلب عرض سعر | احجز جلسة تحديد الحجم
تواصل معنا الآن إذا كان لديك أي استفسار أو رغبة في معرفة المزيد عن خدماتنا وحلولنا المتكاملة، ففريقنا المحترف جاهز لتقديم الدعم والإجابة على كل أسئلتك بسرعة وكفاءة لضمان حصولك على أفضل تجربة وخدمة ممكنة.
الأسئلة الشائعة
س1. ما الفرق بين الأجهزة الأربعة؟
المعمارية واحدة في الأربعة: التبريد السائل ذاته ومنصّة ILM ذاتها. الفرق في الحجم: MicroNode بمسرّعين لمكتب القسم، وSuperNode بأربعة لأحمال الإنتاج المؤسسية، وUltraNode بسبعة للأحجام الكبيرة والتدريب المتواصل، وRackNode بثمانية في هيكل رفّي لمراكز البيانات.
س2. هل نحتاج إلى مركز بيانات لتشغيلها؟
لا. التبريد كامل داخل الجهاز، فلا حاجة إلى مياه تبريد من المبنى ولا أرضية مرتفعة ولا وحدات تكييف خاصة. تعمل الأجهزة البرجية في المكتب أو المختبر، ويُركَّب RackNode في رفّ قياسي دون بنية تبريد إضافية.
س3. هل يمكن البدء بجهاز واحد ثم التوسّع؟
نعم. كل جهاز جاهز للانضمام إلى Constellation منذ تشغيله، فتضيف وحدات جديدة إلى المجموعة نفسها دون إعادة تصميم، ويمكن الجمع بين أجهزة مختلفة في مواقع مختلفة.
س4. ما البرمجيات المرفقة بالأجهزة؟
كل جهاز يصل مع منصّة ILM مثبّتة مسبقًا وترخيص لسنة، وهي تشغّل النماذج المفتوحة وتدرّبها وتراقب الأداء. وفوقها تعمل أنظمة لينامارا الذكية بحسب ما تختاره مؤسستك.
س5. كيف نحصل على عرض سعر؟
عبر نموذج «اطلب عرض سعر» أو جلسة تحديد الحجم؛ فالسعر يرتبط بالتهيئة المختارة ومستوى الخدمة ومتطلبات التركيب، ونعدّه لكل مؤسسة بحسب حاجتها الفعلية.